PRIVATE RESEARCH · 2026-10-21 · 真机实测,不是厂商 Demo
NanoAvatar × Remy
端侧口型与双片段实测
已将两个片段分别预处理,组成固定时间线,喂入连续语音并完成真机推理。没有逐角色训练,也没有修改模型权重。它具备作为端侧口型组件的可行性,但尚未实现 RTA 式动态片段选择、无缝过渡和生产稳定性保障。
新增:Fish Audio 有声参考版 + 实测内存
这段画面由手机上的 NanoAvatar 实际生成,声音是当次输入的 Fish Audio s2-pro 音轨,后期按首帧呈现时间对齐配入。不是手机麦克风/扬声器实录,不作为视听同步验收。它替代了先前机械的测试夹具语音;真实 Fish 网络流直达手机的追加测试已完成,见下方 Streaming 实测;本段视频仍是先前的参考音轨对齐版。
下载 Fish 有声参考版 MP4 · 听原始 Fish 语音 · 完整内存与推理证据
| 实测项目 | 结果 | 含义 |
|---|---|---|
| 设备 / 芯片 | Galaxy S24 Ultra / SM8650 | 骁龙 8 Gen 3,SM-S928U1,Android 14,arm64-v8a。 |
| 内核可见整机 RAM | 约 10.81 GiB | /proc/meminfo MemTotal;不是应用占用。 |
| 应用进程采样最大 PSS | 347.0 MiB | 共享页按比例分摊;约每两秒采样,不是真实瞬时峰值。 |
| 应用进程采样最大 RSS | 478.7 MiB | 驻留页总量;不可与 PSS 相加。 |
| NPU 独立/驱动侧内存 | 未独立测量 | 不能认为全部计入应用 PSS/RSS。 |
| Fish 语音时长 | 8.9235 秒 | 预先生成,再按 40ms 分块送手机;不是本轮端到端网络流。 |
| 实际新口型 / 计算吞吐 | 12.50 / 17.36 FPS | 112 个生成帧呈现,224 个显示帧。 |
| 首次可见 / 首帧计算 | 1,078.7 / 202.6 ms | 从本地分块输入计,不含 Fish 合成与网络。 |
| AudioTrack underrun | 0 | 软件计数;不等于录到了扬声器声音或证明视听同步。 |
运行内存与模型磁盘文件量是两件事。此内存结果覆盖一次短时测试、两个短片段;更多 clips 的预计算缓存、长通话和热降频尚未测量。
先前双片段效果与原片
以下视频来自这次真机屏幕录制。Android screenrecord 没有采集音轨,因此视频为静音;不能据此宣称视听同步已验证。裁剪版本仅去掉手机界面并缩放,没有插帧或美化。原片与输出不是逐帧同步对照。
Remy:手机实际生成画面
双片段固定时间线,连续输入测试语音。新口型更新约 12.5 FPS,身体动作来自原视频。
原始素材:未加新口型
quiet-head-tilt 与 quiet-hair-tuck,各取前 48 帧;以 24 FPS 拼成 96 帧,再沿用往返循环,共 190 帧。
若内嵌播放器被当前浏览器禁用,可使用下方 MP4 下载链接。报告已校验线上 MP4 与本地录屏文件一致;自动化浏览器返回 progressive media disabled,未确认内嵌播放成功。
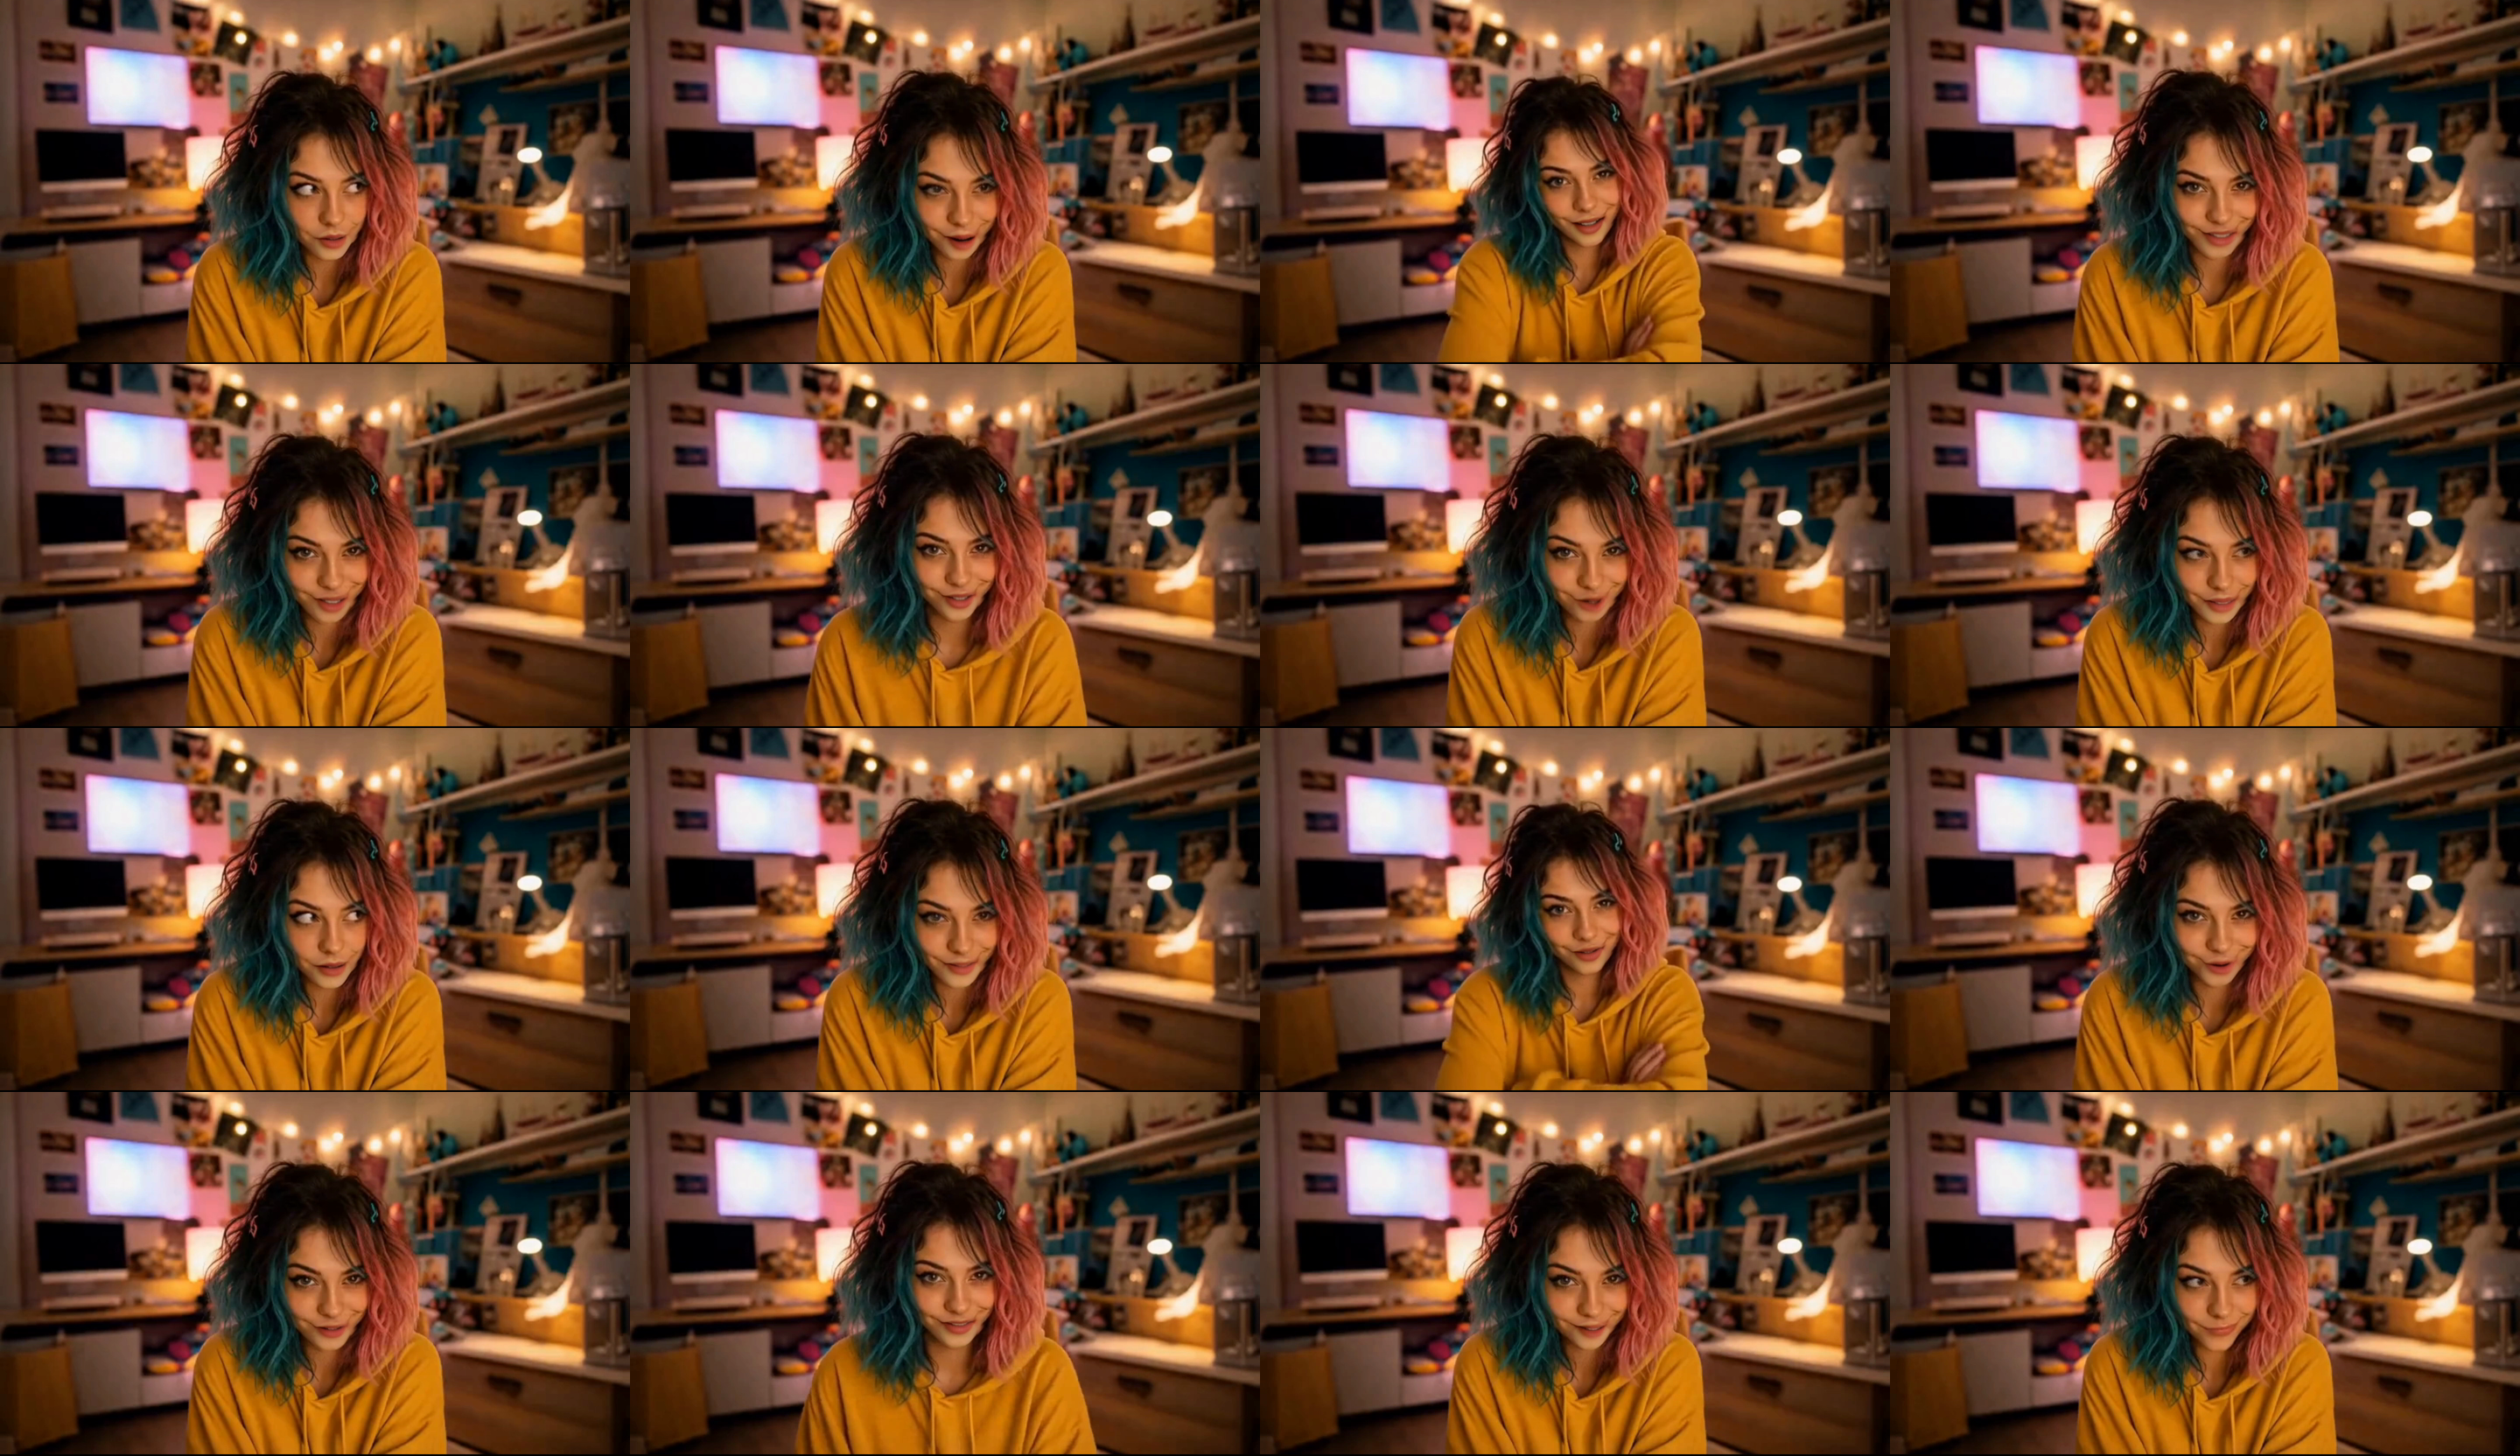
展开完整手机界面录屏
测试语音:下面是单次 4.75225 秒输入,实验重复三次,共 14.25675 秒。它是测试夹具,不是实际用户通话。
第二轮:Remy 双片段实测
| 指标 | 测量 | 解释 |
|---|---|---|
| 音频输入 | 228,108 samples / 16 kHz | 约 14.26 秒,每 40 ms 计划提交 640 samples;UI 调度不是网络模拟。 |
| 收齐 / 提交播放的音频 | 228,108 / 228,108 | 完整输入已提交,最终状态 complete。 |
| 显示帧 / 新生成口型帧 | 357 / 179 | Lite 复用交替帧的嘴部;不能用显示帧数冒充新生成帧数。 |
| 模型开始前的等待 | 770.6 ms | 与原实现约 800 ms 音频窗口一致。 |
| 首帧纯计算 | 223.9 ms | 特征提取开始到首个生成 RGB;不含音频积累和呈现。 |
| 第一张生成 RGB | 994.4 ms | 从本地音频注入开始计。 |
| 第一张生成画面显示 | 1,087.3 ms | 来自实际呈现回调,不是只看模型产出。 |
第一轮官方角色:15.4 compute FPS、218.1 ms 计算首帧,整段语音一次输入;提示框未关闭,不能与第二轮当同条件性能对比。第二轮已关闭提示框。两轮均只有短时、单设备样本,不代表长通话表现。
Lite 到底多大?需要下载吗?
需要。模型可以首次使用时下载并缓存,不必每通电话重新下载。官方演示将模型直接打包进 APK。以下为读取官方 Lite APK 的实际字节统计,MB 为十进制:
| 项目 | 大小 | 范围 |
|---|---|---|
| 完整官方 Lite APK | 214.71 MB | 模型、推理库、示例角色和 UI 全部包含。 |
| 模型在 APK 中的压缩大小 | 180.65 MB | 不含推理运行库和角色。 |
| 模型完全解压后的文件量 | 393.10 MB | 不是最终安装占用;APK、压缩副本和缓存可能另占空间。 |
| 推理库 | 23.35 MB 压缩 / 70.89 MB 展开 | 包括 ONNX/QNN 等。 |
| 官方示例角色素材 | 7.05 MB 压缩 | 不是每个 RTA clip 的固定大小;原始帧、遮罩和参考缓存随素材增长。 |
模型可在多个角色间共用;新增 clips 主要增加素材、预处理特征与缓存,而不是每段再下载一套模型。作者所报约 700 MiB 运行内存没有在本次独立测量,不能当作我们的实测。
能接我们的 RTA clips 吗?
能复用原始视频,本轮已经使用 Remy 的实际片段验证。不能直接复用 RTA 的 LivePortrait 特征缓存;需要按 NanoAvatar 自己的输入准备逐帧人脸裁剪、仿射变换、遮罩和参考特征。
- 模型在一次连续音频会话中跨预先排好的片段运行;不需要为 Remy 重新训练。
- 本次是把两个片段预先组织成一条时间线,不是运行时任选动作。
- 动态调度需要同步切换背景帧、嘴部参考特征和几何信息,并预加载下一片段。
- Lite 会在相邻步复用嘴部 RGB,片段边界尤其需要避免旧嘴部贴到新底片。
- 两段身体姿势仍有硬切;NanoAvatar 不负责自动补身体过渡。
Streaming:真实网络流与打断已跑通
已实跑:分两次送入固定文本 → Fish WebSocket 持续生成音频 → 隔离 HTTP 流中继 → S24 Ultra 边收 PCM 边生成和显示 Remy。没有先下载整段音频再回放;但输入是固定测试文本,不是用户麦克风或实时 LLM 输出。动态动作调度仍未实现。
| 真实网络实测 | 结果 | 边界 |
|---|---|---|
| 首轮请求 → 首块 PCM | 7,896 ms | 包含中继启动、Fish、网络;未拆出各自占比,不能归因给单一环节。 |
| 首轮请求 → 首张生成画面 | 8,413 ms | 比音频网络流结束早约 10.22 秒,证明不等待 EOF。 |
| 首块 PCM → 首张画面 | 约 517 ms | TTS 音频可突发到达,所以 800ms 音频内容不等于必须等 800ms 墙钟。 |
| 网络 EOF | 18,634 ms | 收到和提交播放均为 83,333 samples,约 5.21 秒音频,完整推理结束。 |
| 第二轮请求 → 首块 / 首画 | 约 1,770 / 2,157 ms | 单次追加请求,不是稳态延迟分位数。 |
| 打断 | EOF 前取消 | 取消前后旧生成口型呈现计数均为 19;观察窗口约 1.5 秒,没有继续呈现旧口型。 |
| 模型计算吞吐 | 17.14 FPS | 跨整次请求含静默间隙的新口型呈现均值为 5.85 FPS;不能把它解释为每段连续说话的固定刷新率。 |
结论:支持真实 streaming 与取消,但延迟体验尚未通过产品验收。首轮 8.4 秒、第二轮 2.16 秒都不能包装成亚秒实时通话;还需要降低并测量中继/TTS/网络等待。取消验证的是软件旧帧停止,不是扬声器实录。临时测试中继已经停止。
Fish 的官方 LiveKit 插件提供 HTTP 流式音频输出,以及 /v1/tts/live WebSocket 双向文字/音频流。独立请求实测:第一段文字在 0.007 秒送出,第一块音频在 0.540 秒收到;第二段文字到 3.009 秒才发送,6.010 秒才结束输入。即音频可以在全文完成前返回。
NanoAvatar 真机已验证 40 ms 一块的 PCM 输入,未等整个文件输入完就生成并呈现画面。当前 Android 实现采用 400 ms 生成块 + 400 ms 右侧音频上下文,因此首个完整窗口约 800 ms;实际还要加模型和播放时间。它不是严格零前瞻的因果模型。减少缓冲可能降低首帧等待,但会增加重复音频特征计算并可能损伤口型,需要新一轮质量和性能验证,不能只改一个数字就宣称优化完成。
Fish 测试为单次,不是稳定延迟分位数;只证明增量音频在全文结束前返回,不证明本轮所有文本均完整、正确合成。先前内存/有声参考版使用预生成 Fish PCM;本节追加的真实网络测试没有预存输入音频。两种实验结果分别列示,不混用延迟。
硬件与稳健性判断
目前适合指定骁龙机型的实验,不能作为所有用户的默认端侧方案。实测只有一台骁龙 8 Gen 3;Android 发布模型依赖 Qualcomm QNN/NPU,不代表联发科、Pixel Tensor 或 iPhone 可直接运行。
代码已有有界队列、音频时钟播放、取消和尾音处理,但缺少成熟的动态多片段管理。桌面 Hugging Face 发布缺少必需的口型权重,不能按 README 直接复现桌面推理。未测长时间热降频、低内存、后台恢复、频繁动作切换、耳机路由或网络抖动。
画面观察:抽帧可见新口型开合,身体和背景保留原素材;口腔细节与脸部表情是否达到产品质量仍需带音频盲评。短时跑通不等于可上线。
证据与边界
- 上游源码:
1bdb246dfdf63aa07d339c1a5121c719f4a8f717;官方 Android Lite 发布:v1.0.2-20261014。 - 模型未改动;测试入口只替换语音输入并输出诊断。角色预处理使用公开检测/对齐实现,自建移动素材包。
- 完整 snapshot 被 Android logcat 单条长度上限截断。本报告只采用完整的前缀字段、完整呈现时间数组和独立 FPS 行;不声称拿到了后半段内存或音频 underrun 证据。
- 无 ASR/LLM/TTS 服务调用,无业务密钥,无生产部署。模型非商用授权,测试不构成生产使用许可。
下载实测指标 JSON · 下载手机录屏 · 下载画面裁剪版